論文情報
- 論文名:Exploring Structure-aware Transformer over Interaction Proposals for Human-Object Interaction Detection
- 学会:CVPR (2022)
- 投稿者:Yong Zhang (香港中文大学)
- 被引用数:2 (2022/10/19時点)
- タスク:Human Object Interaction
新規性・差分
- インタラクション提案と空間構造符号化の2段階でHOIを予測
概要
- 画像内のヒトとモノのインタラクションを検出する.例えば,人間がバットを握っているなど.
- ヒトとモノのインタラクション候補を提案し,意味構造・空間構造とともに予測を行う.
ネットワーク
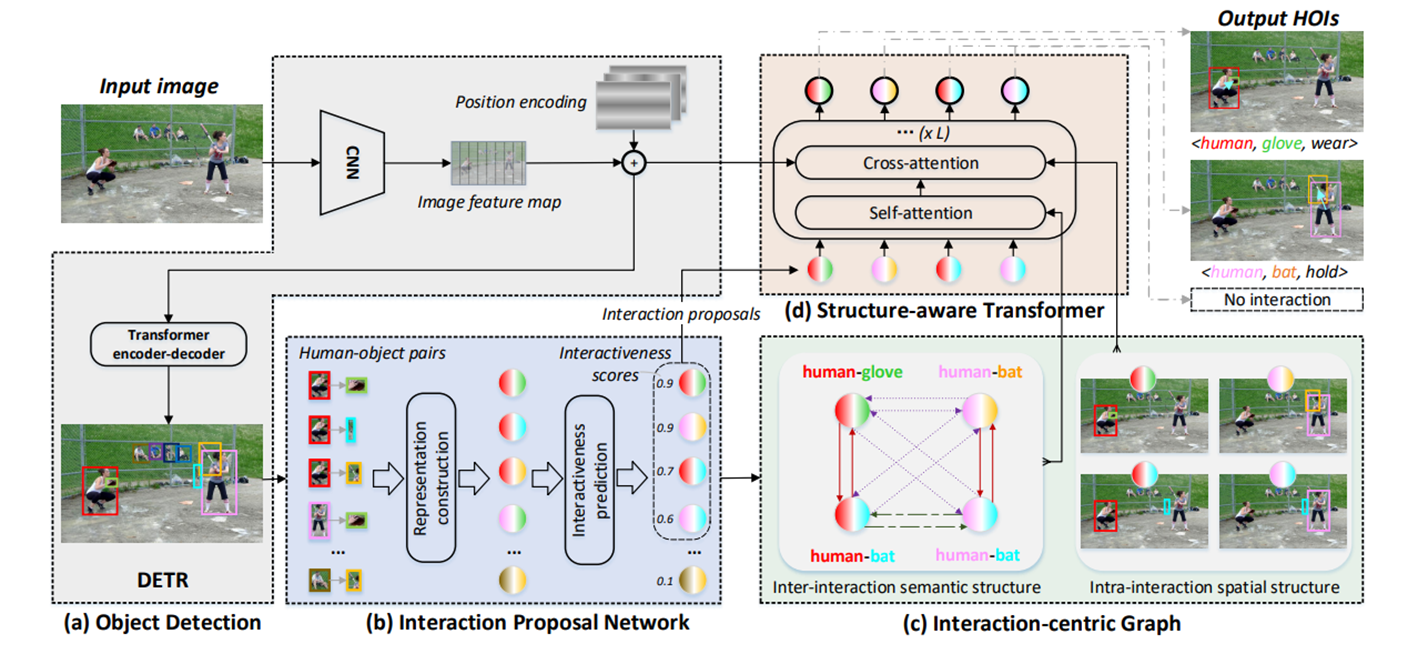
- (a)のDETRを使用してヒトとモノを検出
- DETRによって特徴表現も得られる
- (b)のIntaraction Proposal Networkを使用してインタラクションペアを提案
- ヒト特徴表現とモノ特徴表現とそれらのIOUからインタラクションスコアを予測し,それに基づいてインタラクション候補を提案
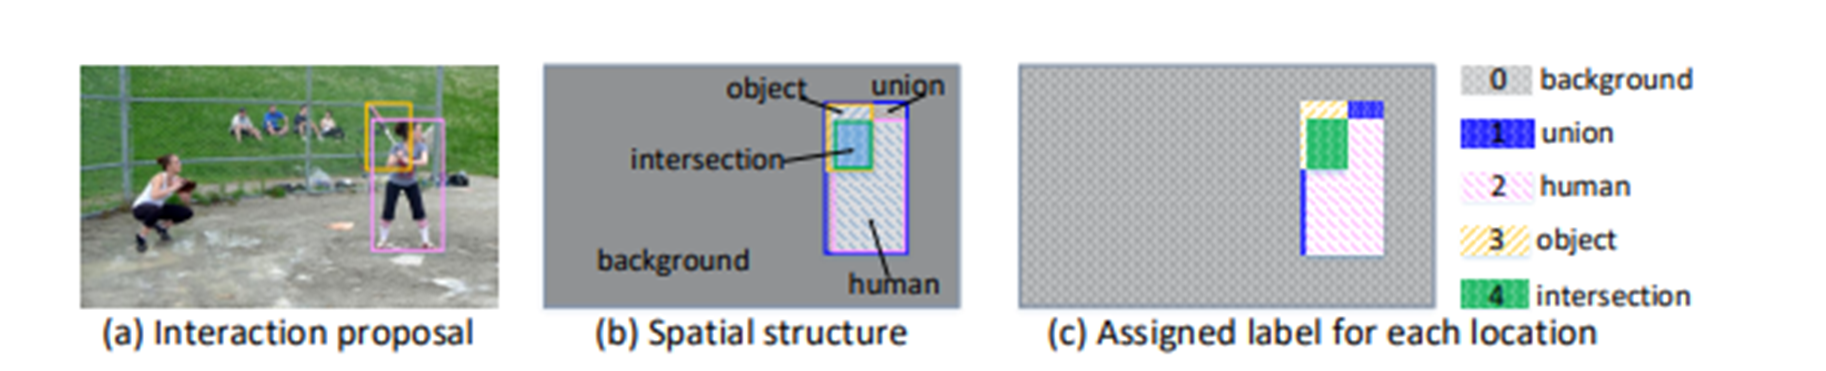
- ヒト特徴表現とモノ特徴表現とそれらのIOUからインタラクションスコアを予測し,それに基づいてインタラクション候補を提案
- ヒトとモノの空間構造を考慮するために画像をラベル化
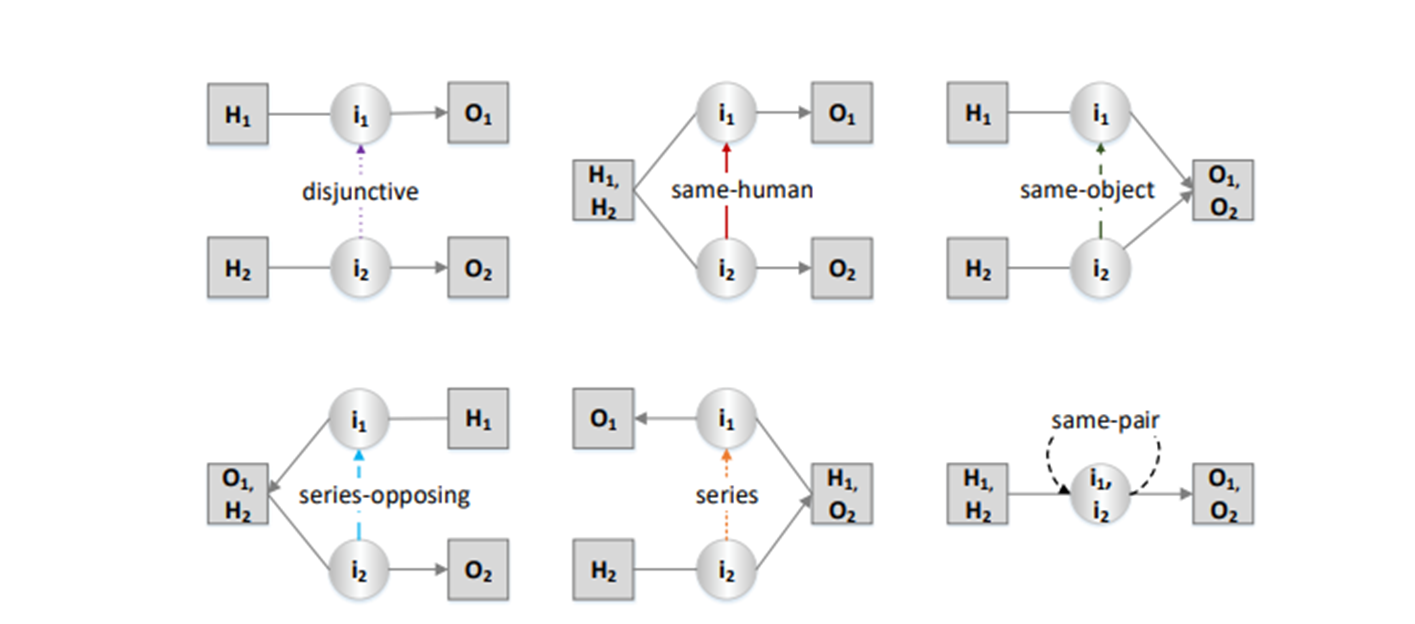
- インタラクション同士の関係性を考慮
- 例えば,2つのHOIのHumanの部分が一致している場合,そのHOIの関係性は「同一ヒト」とされ、関連があることを示す
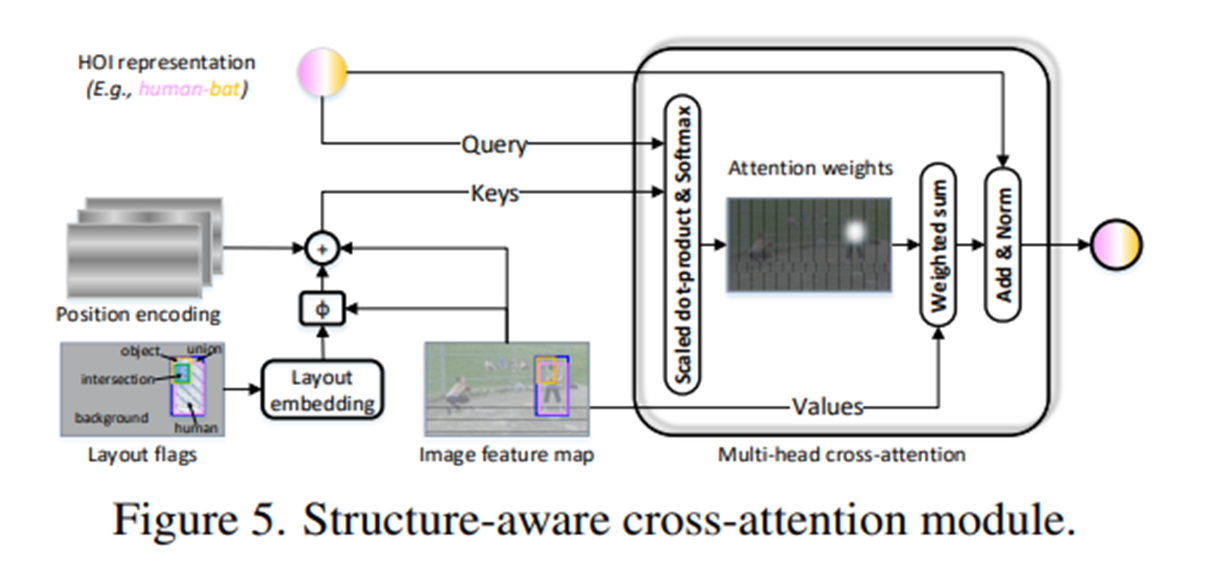
- 例えば,2つのHOIのHumanの部分が一致している場合,そのHOIの関係性は「同一ヒト」とされ、関連があることを示す
- 画像情報とインタラクション情報を統合してHOI表現を獲得する機構
- 最終的にこの出力をMLPに入力し,holdやwearなどの動詞,あるいはインタラクションなしといったインタラクションを予測
所感
- 画像外観情報,空間構造,インタラクション情報を統合的に取り入れることに成功したネットワークであるように思います.
- Interaction Proposal Networkから提案された候補を直接MLPに入力してもそれなりに予測ができそうな気がします.